
KI-basierte Grounding-Pipeline
Wie wir bei Hony Company die regionale Eventrecherche automatisiert haben – von Gemini-Grounding über deterministische Parser bis hin zur Review-UI auf einem lokalen NAS. Diese Pipeline liefert täglich die Basisdaten für ein neues Event-Portal.
Client
hony company
Service
End to End
Industrie
Öffentliche Hand & B2C
Datum
Dezember 2025
Challenge
Regionale Veranstaltungsdaten sind ein chaotisches Ökosystem. Jede Kommune pflegt eigene HTML-Fragmente, PDFs oder Tabellen. KI findet zwar Quellen – aber daraus wird kein strukturierter Datensatz.
AI-gestützte Recherche (Gemini / VertexAI) liefert Links, Redirects und große Tabellen voller Sonderzeichen, unklarer Datumsformate und uneinheitlicher Preislogiken. Duplicate-Gefahr und Redirect-Strecken erschweren Vertrauen.
Manuelle Korrekturen sind nötig, aber nur tragbar, wenn Rohmaterial vorher normalisiert wird. Unser kommendes Event-Portal sollte nicht an der Basis scheitern – also mussten wir dieses Durcheinander in eine belastbare Struktur verwandeln.
Solution
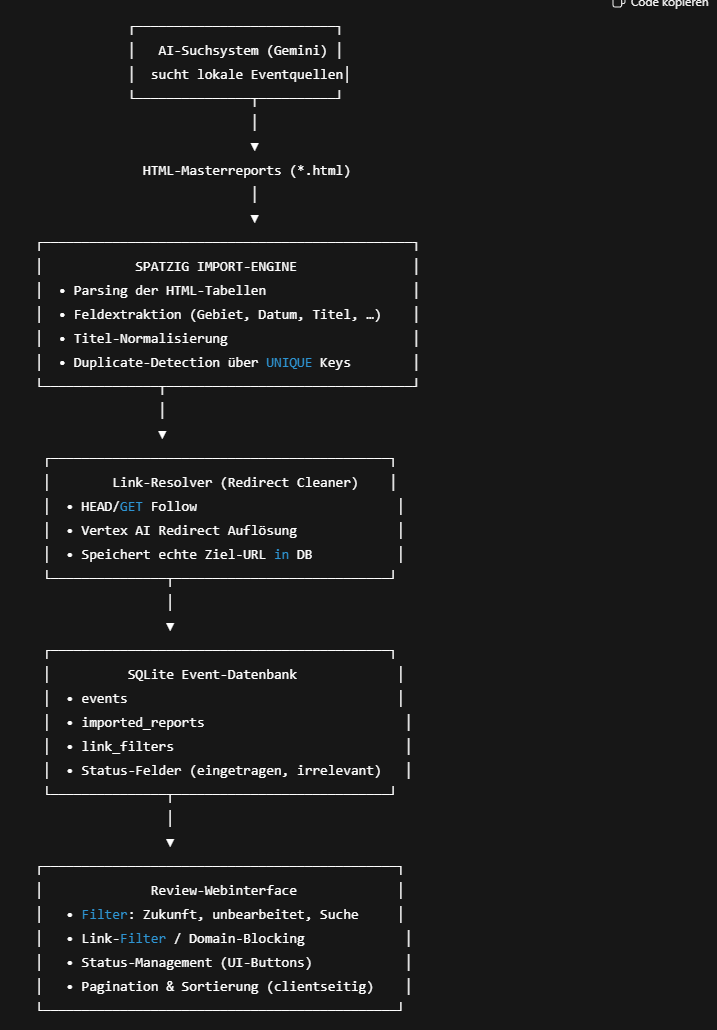
Unsere Architektur besteht aus zwei Schichten, die als Docker-Stack auf einem lokalen NAS laufen: AI-Recherche mit Gemini sowie ein deterministischer Scraper (Importer + Link-Resolver) mit SQLite-Backend.
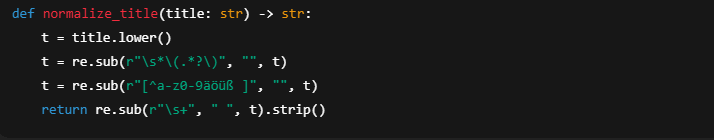
Gemini liefert HTML-Reports mit Roh-Links und Tabellen. Der Importer (import_events.py) zerlegt jede Datei in klare Felder (Gebiet, Datum, Titel, normalisierte Titel, Preise etc.), entfernt Klammern/Sonderzeichen und schreibt alles in eine SQLite-Datenbank. UNIQUE(recherche_ort, datum, titel_norm) verhindert Duplicates.
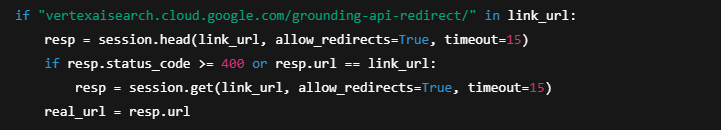
Ein zweiter Container löst VertexAI-Redirects auf, speichert reale Ziel-URLs, beachtet Rate-Limits und arbeitet Batch-basiert. Beide Services laufen isoliert, starten über Cron/Scheduler und persistieren auf NAS-Volumes.
Infra & Review UI
Warum Docker auf einem lokalen NAS? Isolation der Services, portabler Speicher (SQLite-Datei), Ressourcen-Kontrolle und kein Public Exposure. Importer, Resolver und Review-Frontend laufen als getrennte Container. Backups sind reine Storage-Aufgaben.
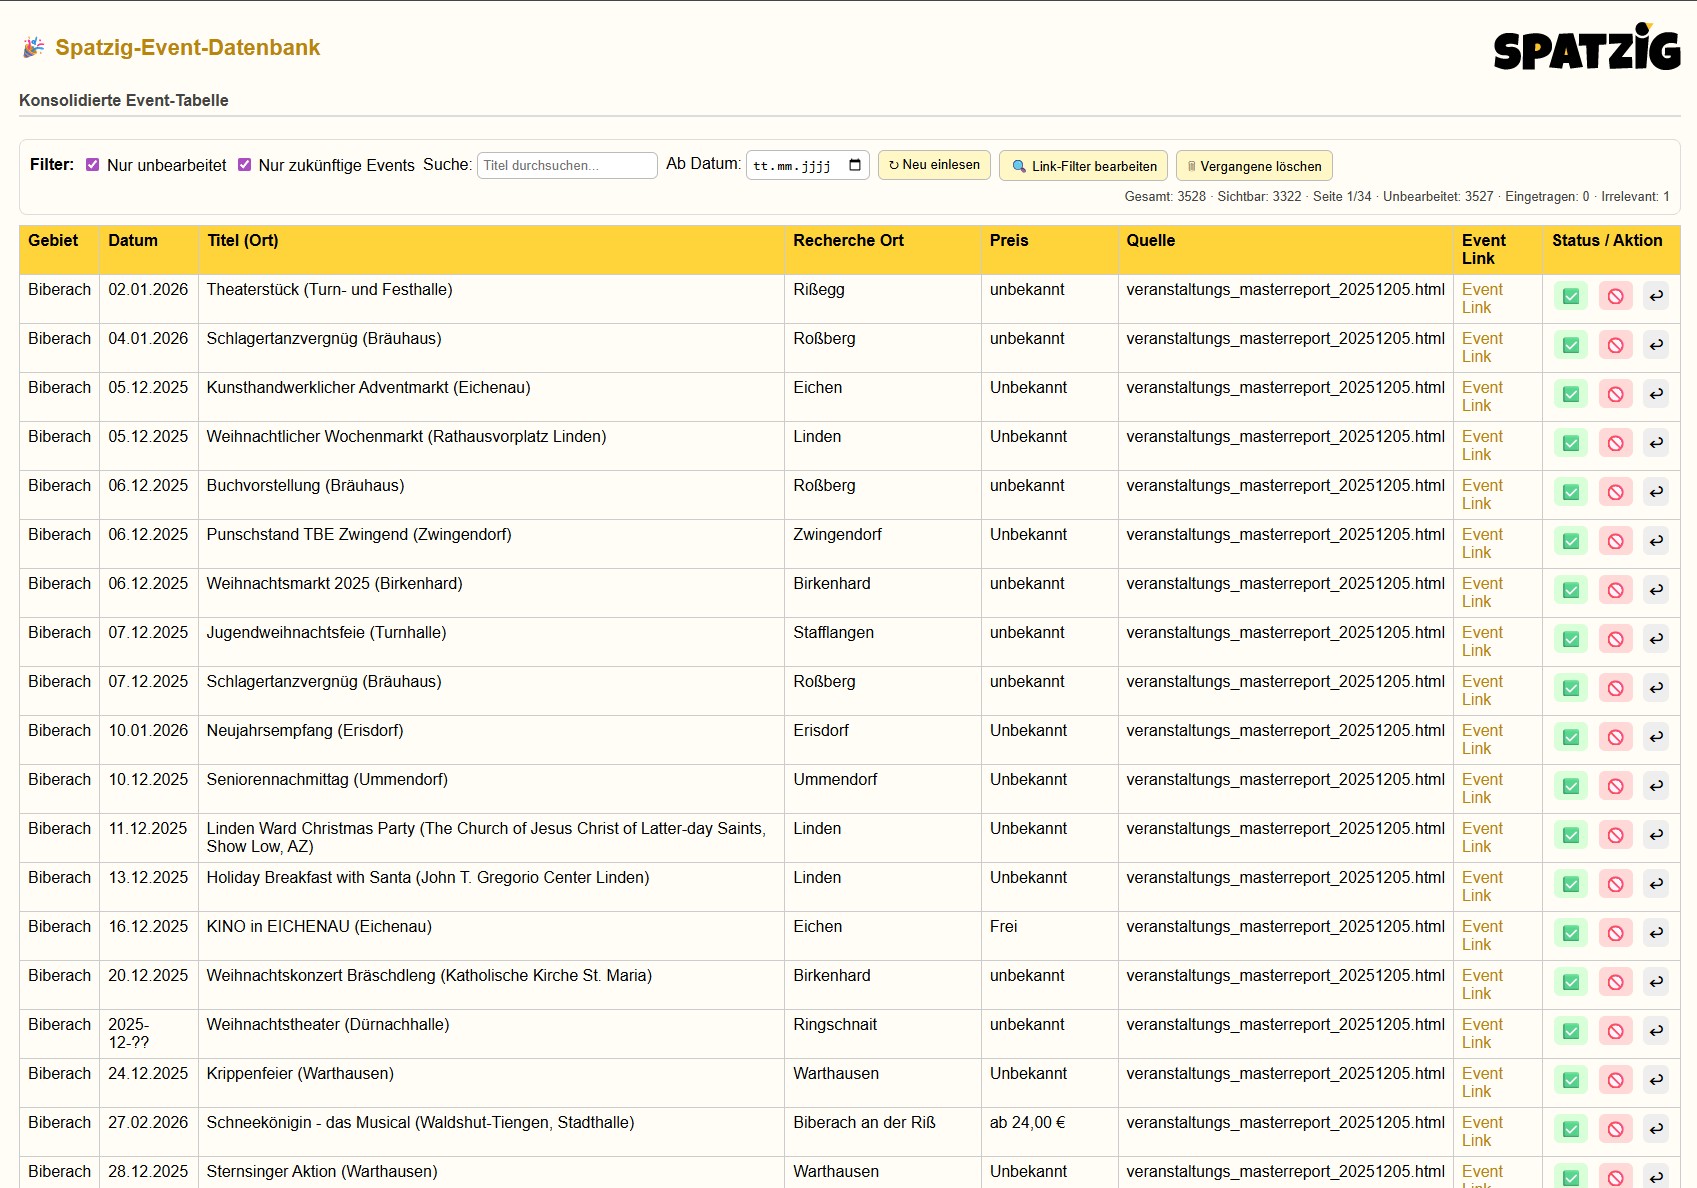
Das Review-Interface ist ein leichtes HTML/JS-Frontend, das per API auf die SQLite-DB zugreift. Funktionen: Filter, Sortierung, Markierungen, Löschroutine inkl. VACUUM, Domain-Filter, Pagination über Tausende Einträge. Logik findet im Browser statt, der Webservice liefert nur Daten.
Automatisierung liefert Breite, deterministisches Parsing sorgt für Präzision, der Resolver gibt Verlässlichkeit – und Menschen kuratieren die finale Liste. So wird das kommende Portal zu einer Plattform mit geprüften Eventdaten statt KI-Auswürfen.
Impact
Das Portal kann so täglich aktualisierte, geprüfte Events aus einer Region bereitstellen. Veranstalter erhalten Sichtbarkeit, Eltern sparen Zeit, und wir können künftig weitere Regionen anbinden, indem wir nur die AI-Reports tauschen.
Die Pipeline lässt sich auf andere Domänen übertragen: lokale Angebote, Vereinsdaten, Tourismusinformationen. KI liefert Ideen – unsere Infrastruktur macht sie belastbar.
Entwickler
Feedback
„Die AI-Reports waren Rohmaterial. Erst mit dem Importer, dem Link-Resolver und der Review UI wurde daraus ein reines Datenprodukt. Jetzt haben wir endlich verlässliche Eventlisten – ohne händisch 300 Webseiten abzusurfen.“
Daniel Hohneker
hony company
 Eure Story – Block für Block, Spell für Spell.